Wer generative KI produktiv einsetzt, kennt das Gefühl: Was als kleines Experiment beginnt, wird schnell zum spürbaren Kostenblock. Ein Agent, der automatisiert hunderte Anfragen abarbeitet, eine wachsende Nutzerzahl, ein Prompt, der „nur mal eben“ ein bisschen länger wird und plötzlich muss das monatliche KI-Budget zum dritten Mal in Folge erhöht werden.
Der häufigste Berührungspunkt mit KI ist der Chatbot: Eine Anfrage geht rein, eine Antwort kommt raus. Dahinter steckt ein Large Language Model (LLM), das nicht „weiß“, sondern rechnet. Auf Basis des mitgelieferten Kontexts berechnet es Schritt für Schritt die Wahrscheinlichkeit für das jeweils nächste Textfragment – den Token.
Ein Token ist dabei weder ein Wort noch ein Zeichen, sondern eine kleine Texteinheit. Als grobe Faustregel gilt: Ein Token entspricht etwa drei Vierteln eines englischen Wortes, im Deutschen sind es wegen der oft längeren Wörter tendenziell etwas mehr – 100 Wörter liegen ungefähr bei 100 bis 140 Tokens. Wie ein Text exakt in Tokens zerlegt wird, hängt aber vom jeweiligen Modell und dessen Tokenizer ab. Die Zahl ist also eine Orientierung, keine feste Konstante.
Warum das wichtig ist: Bei tokenbasierten APIs richten sich die Kosten nach Anzahl und Art der verarbeiteten Tokens. Alles, was eingegeben und generiert wird, zählt und wird abgerechnet.
Jede Anfrage lässt sich in vier Schritte zerlegen: Input (Prompt, Schema, Dokumente, Verlauf) wird verarbeitet (Kontext plus Aufgabe) und erzeugt einen Output (Antwort, ggf. Reasoning). Hinzu kommen Prompt-Teile, die bei einem vorherigen Aufruf bereits verarbeitet wurden und deren Zwischenergebnis der Anbieter zwischenspeichert: Diese Cached Tokens müssen nicht neu berechnet werden und sind deshalb günstiger. Daraus ergeben sich die Kosten:
Input-Tokens × Preis + Output-Tokens × Preis + Cached Tokens × Preis = Kosten pro Anfrage
Wichtig dabei: Output-Tokens sind bei den meisten Modellen deutlich teurer als Input-Tokens, gecachte Tokens dagegen am günstigsten. Reasoning- bzw. Thinking-Modelle nutzen zusätzlich interne Verarbeitungsschritte, bevor sie antworten – das bedeutet in der Regel mehr Output-Tokens, höhere Kosten und längere Antwortzeiten.
Vier Stellschrauben entscheiden maßgeblich über die Höhe der Rechnung:
Modellwahl – Würde für diese Aufgabe auch ein kleineres, günstigeres Modell reichen?
Prompt-Länge – Was wird wirklich gebraucht, was ist nur Ballast?
Output-Länge – Wie lang muss die Antwort tatsächlich sein?
Anzahl der Requests – Wie oft wird die Anfrage gestellt, insbesondere automatisiert?
Gerade der letzte Punkt wird bei Agenten zum Problem: Ein einzelner ineffizienter Aufruf fällt kaum auf. Schickt ein Agent aber bei jedem Schritt den kompletten bisherigen Verlauf erneut mit, vervielfacht sich die Ineffizienz mit jeder Wiederholung – aus einer kleinen Unsauberkeit wird bei tausend Durchläufen ein echter Kostenblock.
Das Kontextfenster bestimmt, wie viel Verlauf, Anweisungen und Zwischenergebnisse in einem einzelnen Modellaufruf mitgeschickt werden können. Bei Agenten-Workflows mit mehreren Schritten wächst dieser Kontext von Aufruf zu Aufruf und mit ihm die Kosten.
Prompt Caching hilft dabei, wiederkehrende Teile eines Prompts (etwa einen gleichbleibenden System-Prompt) günstiger wiederzuverwenden. Aber: Caching macht den Verlauf nicht kostenlos, sondern nur billiger. Zudem ist der Cache nur begrenzt gültig: Je nach Anbieter verfällt er nach wenigen Minuten bis hin zu Stunden ohne Nutzung, teils lässt sich die Dauer gegen Aufpreis verlängern. Ein sehr langer, mehrfach wiederverwendeter Kontext kann sich trotzdem spürbar aufsummieren. Vier Strategien helfen, den Kontext schlank zu halten:
Zusammenfassen – ältere Inhalte komprimieren statt im Volltext mitzuschleppen
Vergessen – nicht mehr relevante Schritte bewusst aus dem Kontext entfernen
Aufteilen – Teilaufgaben in getrennte Sessions auslagern, statt alles in einem Mammut-Chat zu bündeln
Begrenzen – feste Obergrenzen und Abbruchkriterien setzen, besonders bei automatisierten Agentenläufen
Um die Theorie greifbar zu machen, haben wir ein eigenes kleines Reporting-Tool gebaut: Natürliche Sprache wird in SQL übersetzt – eine Frage wie „Wie viele Produkte haben wir verkauft?“ generiert im Hintergrund die passende Datenbankabfrage, ganz ohne SQL-Kenntnisse beim User.
Unsere Projekterfahrung hat gezeigt, dass so ein Tool in quasi jedem gewachsenen Softwareprojekt interessant ist. Spontane Reports und Insights zu den eigenen Daten sind Gold wert.
Getestet wurde mit drei frei verfügbaren Open-Weight-Modellen (gpt-oss-20b, Gemma 4, Nemotron 3 Nano) über Ollama Cloud.
Dabei zeigten sich drei Effekte sehr deutlich:
Jedes Modell tokenisiert anders. Bei identischer Frage und identischem Prompt unterschied sich die Anzahl der Input-Tokens zwischen den Modellen teils erheblich.
Versteckte Kosten lauern im technischen Kontext. Weil im Hintergrund bei jeder Anfrage das Datenbankschema mitgeschickt wird, kosteten unnötige, nicht gebrauchte Zeilen im Schema spürbar mehr Tokens – bei gleichem Ergebnis.
Ausführliche Prompts bringen nicht automatisch bessere Antworten. Ein auf Stichpunkte reduzierter, präziser Prompt lieferte dasselbe korrekte Ergebnis wie eine stark ausformulierte Variante mit Rollenbeschreibung, Regeln in ganzen Absätzen und zusätzlichen Beispielen – nur mit deutlich weniger Tokens.
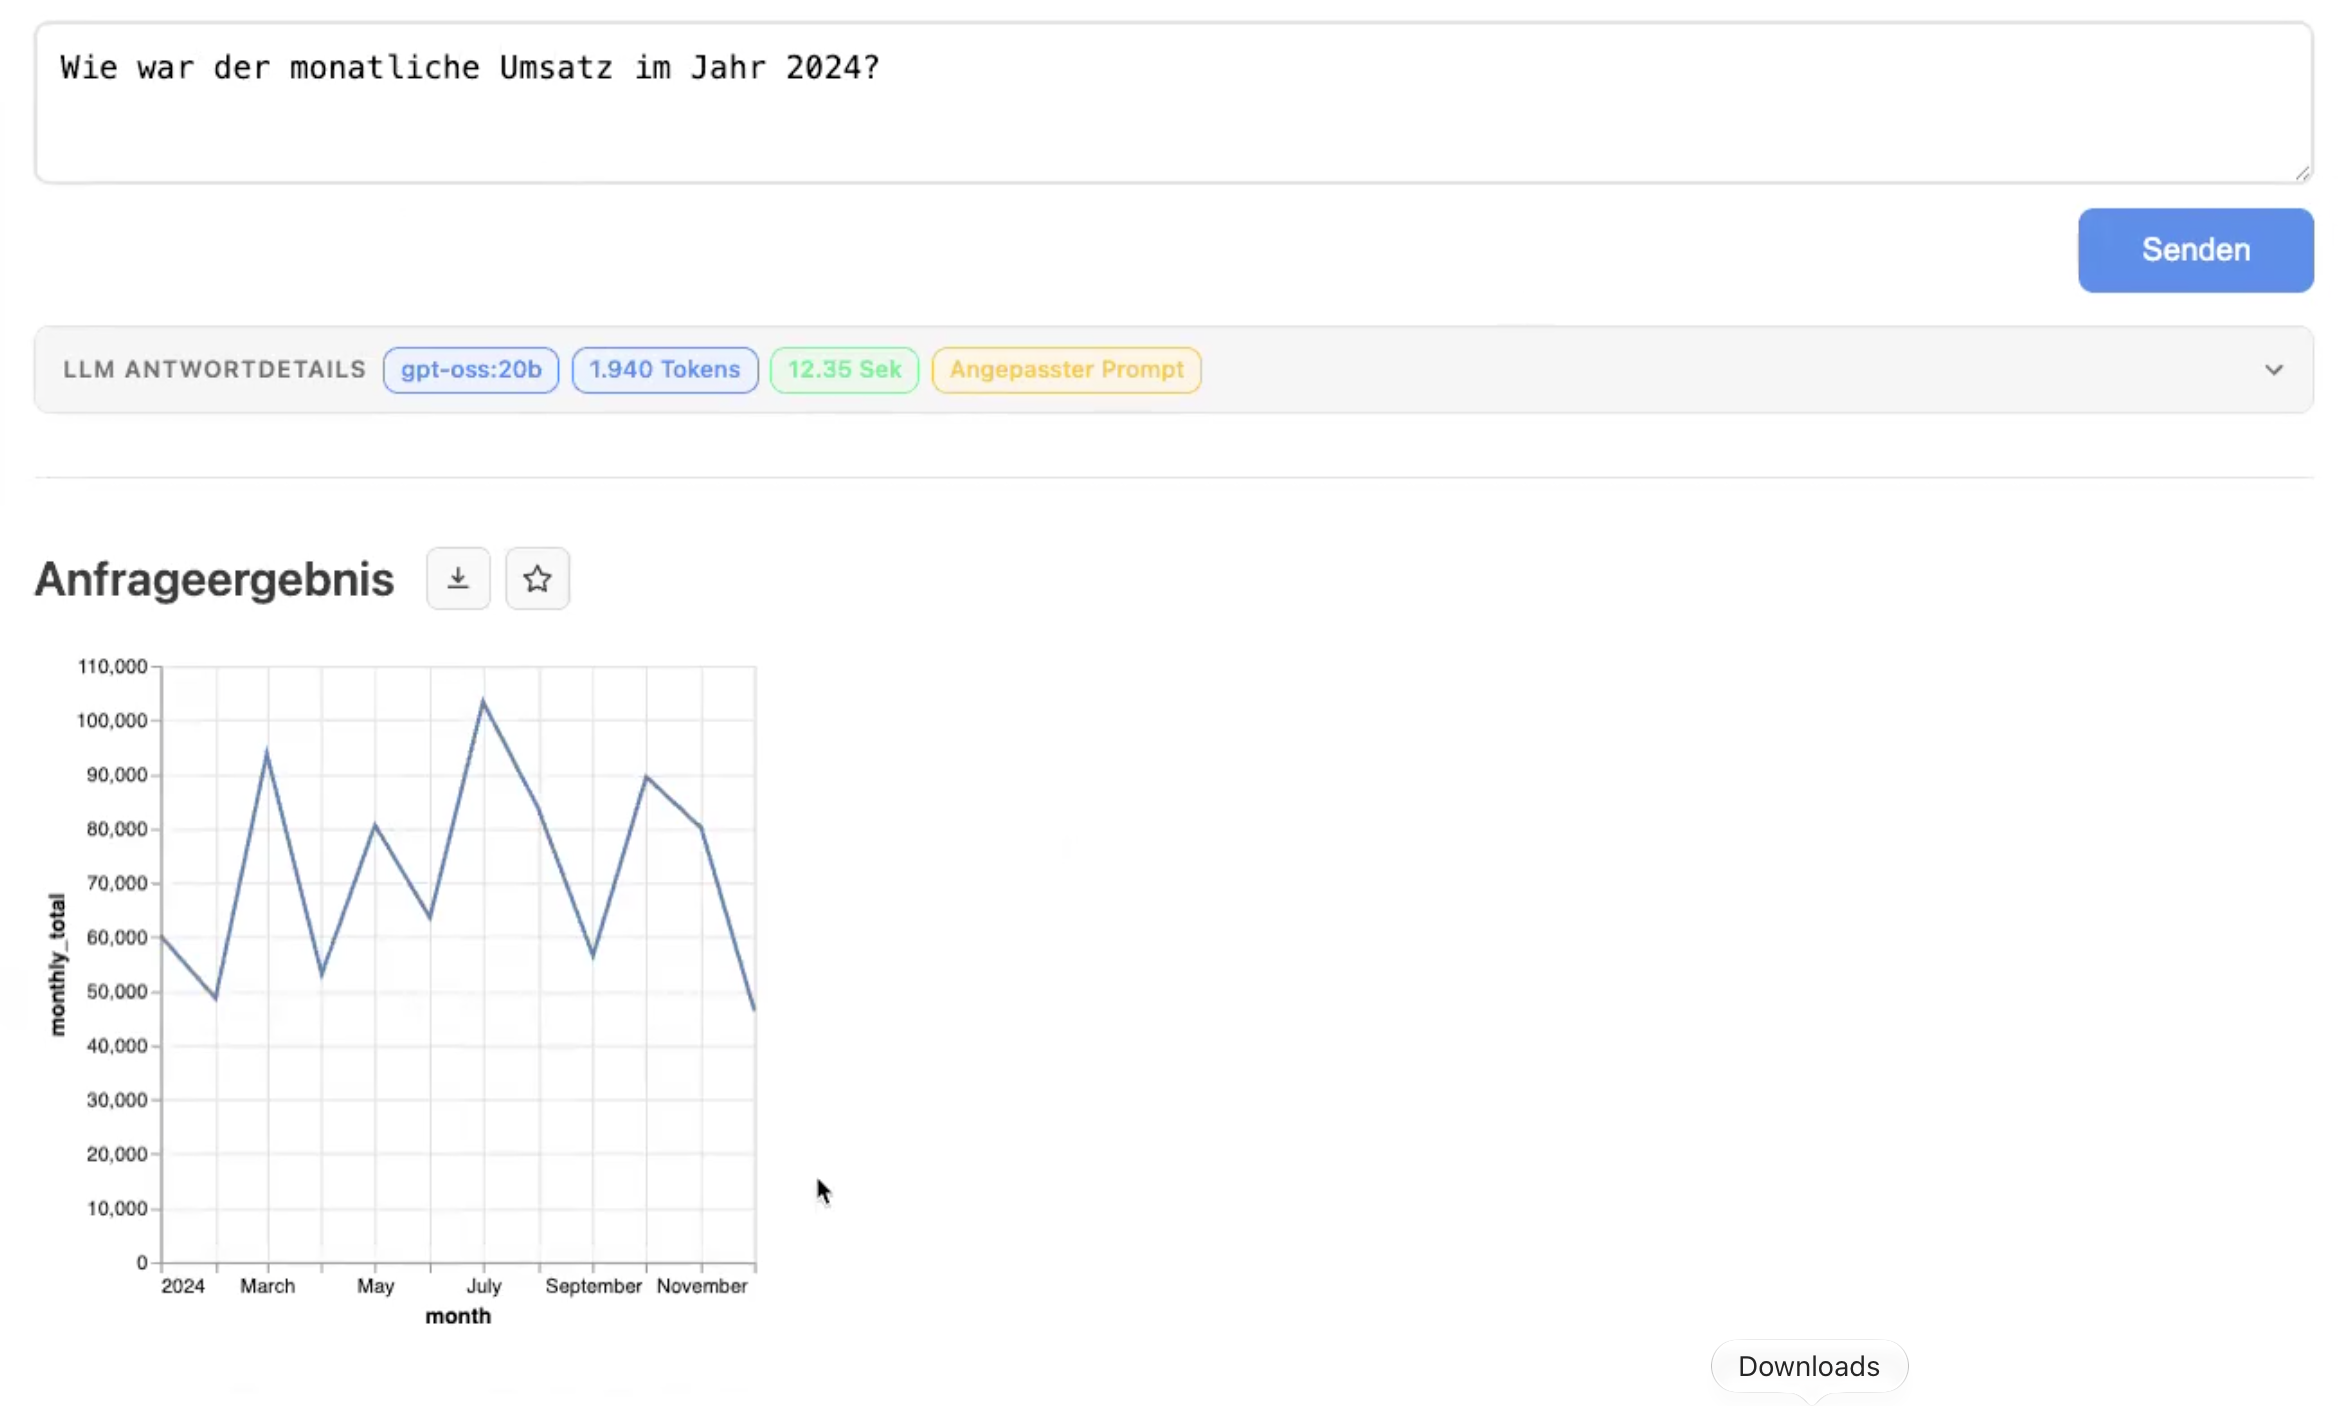
Wie stark sich das am Ende auswirkt, zeigt die Hochrechnung auf einen realistischen Nutzungsfall:
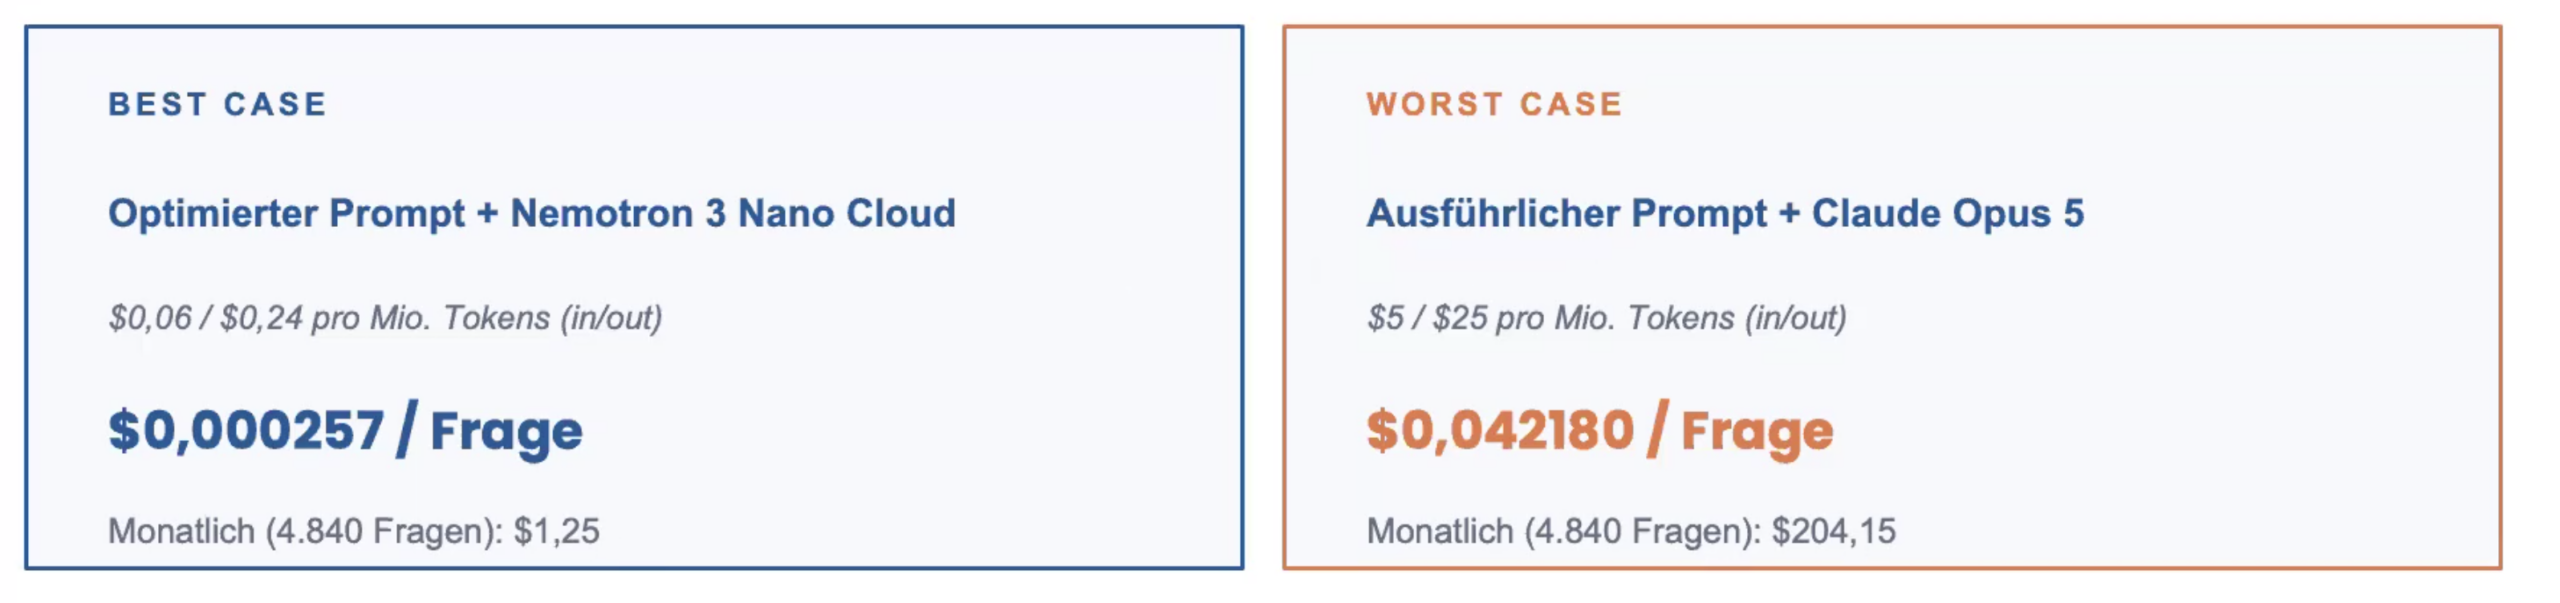
Bei identischem, korrektem Ergebnis liegt zwischen beiden Setups ein Faktor von 164. Monatliche Kosten von $1,25 statt $204 machen einen großen Unterschied für so ein kleines Tool.
Der schnellste Hebel ist dabei nicht zwangsläufig das Prompt-Tuning, sondern oft schon die Modellwahl – wer für eine Aufgabe eigentlich kein Frontier-Modell braucht, spart allein dadurch den Großteil der Kosten.
Ein Punkt, der in der Praxis oft übersehen wird: Nicht nur der produktive Betrieb kostet Tokens, auch automatisierte Tests. Wer KI-Funktionen laufend testet, lässt oft tausende Testfälle hintereinander laufen und das kann sich zu einem Kostenblock summieren, der am Ende höher ausfällt als die eigentliche Produktion.
Das richtige Modell wählen – nicht das stärkste, sondern das für die Aufgabe ausreichende.
Output bewusst begrenzen – klare Formatvorgaben (Länge, Struktur) sparen die teuerste Token-Kategorie.
Prompts präzise halten – auch Beispiele im Prompt müssen relevant sein, sonst sind sie nur Ballast.
Kontext aktiv verwalten – komprimieren, vergessen, aufteilen, begrenzen.
Kosten laufend messen – Modelle, Preise und das eigene Nutzungsverhalten ändern sich schnell.
Wer die eigenen KI-Kosten systematisch im Blick behalten will, muss nicht bei null anfangen:
ccusage – kostenloses Open-Source-Kommandozeilen-Tool, das den Tokenverbrauch unterstützter Coding-Agent-CLIs pro Tag, Monat oder Session auswertet.
Langfuse – Open-Source-Observability-Plattform (auch selbst hostbar) zum Nachverfolgen von Tokenverbrauch und Kosten über mehrstufige Agenten-Workflows hinweg.
Helicone – laufendes Monitoring über eine große Zahl an Modellen und Anbietern hinweg.
LiteLLM / Bifrost – Gateways, die automatisch zum passenden Modell routen und definierte Budgets technisch durchsetzen.
Manchmal lohnt sich zusätzlich ein eigenes kleines Dashboard, zugeschnitten auf den konkreten Anwendungsfall – genau wie in unserem Praxistest.
KI-Kosten sind kein fixes Abo, sondern das Ergebnis vieler kleiner Entscheidungen: welches Modell, wie lang der Prompt, wie knapp der Output, wie sauber der Kontext verwaltet wird. Keine dieser Stellschrauben ist für sich genommen dramatisch – aber in der Summe, und erst recht bei Agenten mit tausenden automatisierten Durchläufen, entscheiden sie darüber, ob eine KI-Anwendung ein paar Dollar oder mehrere hundert Dollar im Monat kostet. Wer Tokens von Anfang an mitdenkt und die eigenen Kosten regelmäßig misst, behält die Kontrolle, auch wenn sich Modelle und Preise im KI-Markt weiterhin schnell ändern.
Fragen zur Tokenoptimierung in euren eigenen KI-Anwendungen oder Interesse an einer individuellen Kostenanalyse? Meldet euch gerne bei uns.